 Evg
Сегодня 13:48
Вопрос ИИ по поводу stihi.ru и lib.ru (в контексте sugata.ru)
Хороший вопрос. Разберу оба примера — как они устроены технически (мгновенная отдача при огромных каталогах).
stihi.ru — как работает
Это НЕ статический HTML. Стихи.ру — это живой бэкенд + кэш:
- Огромная база стихов (миллионы) живёт в БД.
- Страницы отдаются через бэкенд (Perl-приложение, исторически), но с агрессивным кэшированием — часто собранные HTML-файлы сбрасываются в кэш при изменении/добавлении стиха, а читателю отдаётся готовый файл.
- Ключевое: на странице стиха нет сложной динамики — почти статичный контент + комментарии/счётчики грузятся отдельными запросами. Поэтому файл-кэш почти всегда готов: отдача = дисковый read, мгновенно.
То есть это гибрид: люди редко правят стих, зато много читают → дорого генерировать один раз, потом отдавать кэш тысячи раз. Ровно ваш паттерн «static-first».
Либрусек (библиотека Машкова) — как устроена
lib.ru — тоже не чистый HTML:
-
Это классический сайт 90-х: фактически там уже всё лежит файлами (каталог
.txt/.htmlтекстов книг на диске). Бэкенд только строит обложки (каталоги/списки) из структуры папок и индекса. - Тексты — обычные файлы, отдаются веб-сервером напрямую + кэшируются. Поэтому мгновенно: nginx отдаёт файл без приложений.
- Каталоги (страницы авторов/жанров) — генерируются на лету из папок или тоже кэшируются.
lib.ru по сути ближе к вашему проекту, чем stihi.ru: файлы как источник контента, приложение лишь строит навигацию/индексы.
Что общего и чему учит
Оба показывают один принцип:
Контент, который редко меняется, надо отдавать файлами/кэшем, а не генерировать на каждый запрос.
| Аспект | stihi.ru | lib.ru | Ваш Sugata |
|---|---|---|---|
| Источник | БД | Файлы на диске | БД → HTML-файлы |
| Отдача | Кэш-HTML | Файлы напрямую | Файлы напрямую |
| Живое | Комментарии, счётчики | Поиск, обложки | (пока нет) |
| Скорость | Мгновенно (кэш) | Мгновенно (файлы) | Мгновенно (файлы) |
Ваш текущий подход (полностью статический HTML) — уже лучший вариант для отдачи: как lib.ru, только с генератором. stihi.ru использует кэш-файлы как оптимизацию живого приложения — вам это не нужно, пока нет динамики.
Вывод: оба примера подтверждают вашу архитектуру. Единственное, что они добавляют по сравнению с вами — живые островки (комментарии, счётчики), которые грузятся отдельно, не замедляя основную отдачу файлов.
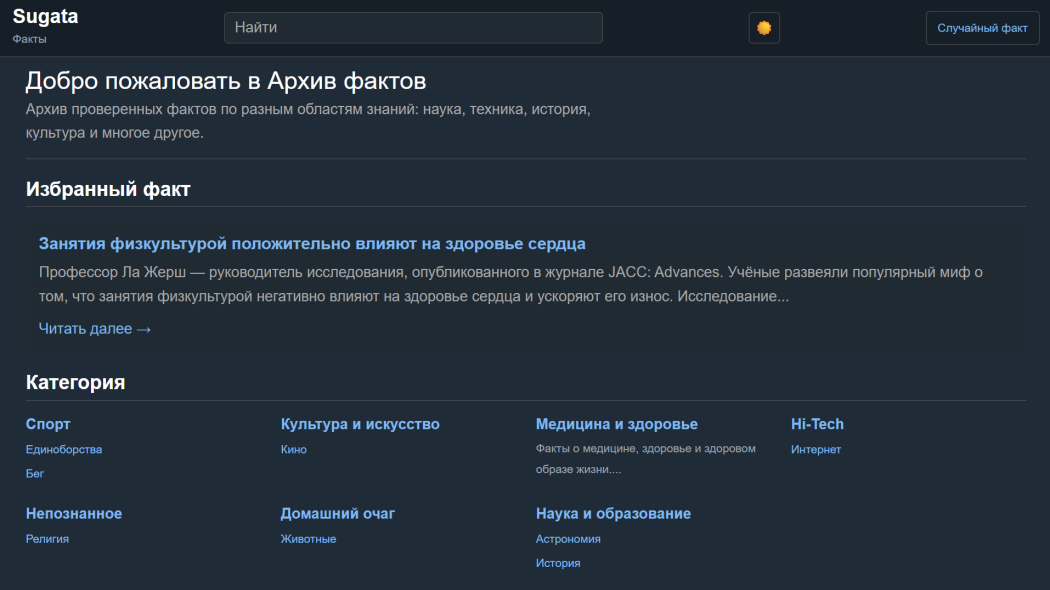
Разговор идет про: https://sugata.ru
Ещё есть LiveJournal написано на Perl (это его архитектурная база с 1999 года, когда Брэд Фицпатрик создал движок). Код был открытым — существовал проект LJ codebase (репозиторий на GitHub от команды ЖЖ), и на его базе поднимались сторонние инстансы. Это одна из причин, почему вокруг ЖЖ было много технической документации и форков.
Что конкретно на Perl:
~
Вот ещё один: https://github.com/dreamwidth/dreamwidth